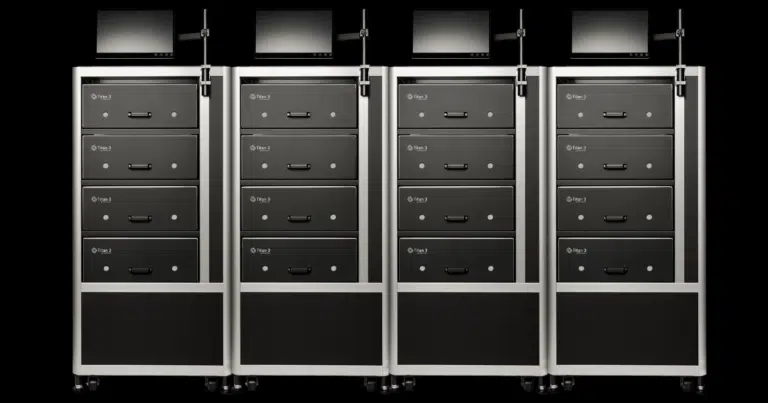
Reconext 已在我们的纽约数据中心上线了三台全新的 AI 专用服务器!这些系统由内部拥有并运营,专门用于 AI 开发和模型部署。
这对您的计划意味着什么
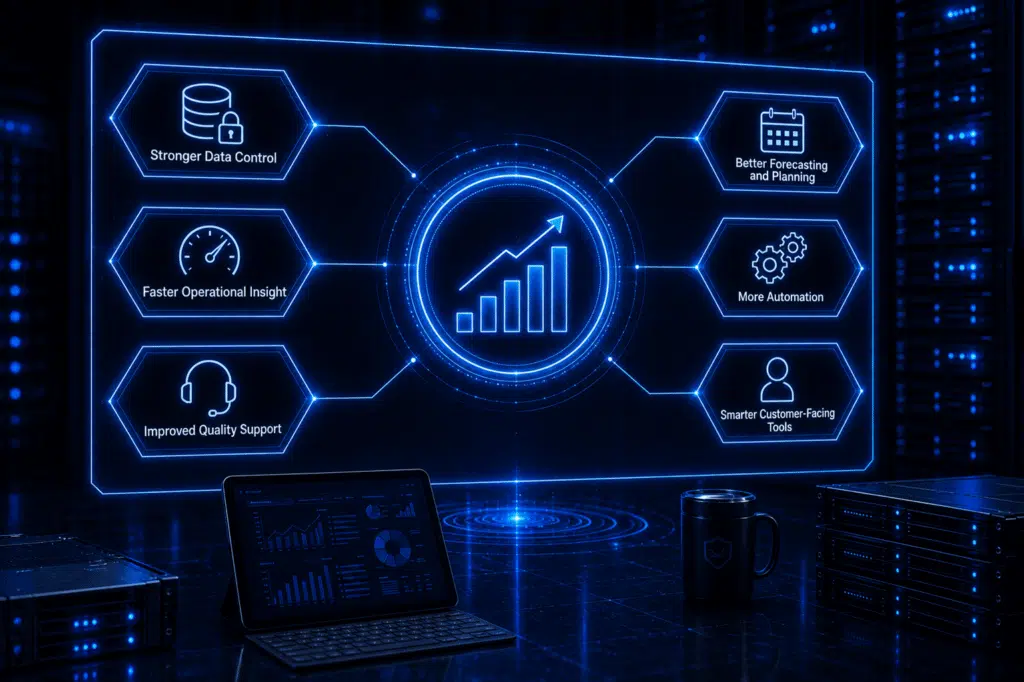
Reconext 目前在自己的数据中心运行着 24 个 AI 加速器,所使用的硬件与主要 AI 实验室用于大规模语言模型训练的硬件属于同一级别。这在实践中意味着:
更强大的数据控制
敏感工作负载在 Reconext 管理的基础设施内进行处理。客户数据无需流经外部云环境即可实现 AI 功能。
更快速的业务洞察
凭借内部专用算力,Reconext 团队可以更轻松地进行分析,并比人工审核更快地发现模式、异常和性能趋势。
改进的质量支持
内部 AI 能力让 Reconext 能够以其他方式难以实现的规模构建并运行检测、诊断和异常处理支持,从而为质量敏感型流程带来更高的一致性。
更好的预测与规划
预测性分析可以在需求模式和流程风险演变成问题之前识别它们。专用算力使这些模型成为常态化工具,而非偶尔使用的工具。
更高程度的自动化
文档审核、工作流路由、报告和数据提取是 AI 可以接管手动工作的领域。这一基础设施使 Reconext 团队有能力大规模构建并运行这些自动化流程。
更智能的面向客户工具
该基础设施支持未来的仪表板和服务智能工具,让客户能够更好地了解其计划,且双方均无需投入手动精力。
工作原理
目前有三台服务器在我们的纽约数据中心运行,共提供 24 个 AI 加速器和约 1.25 TB 的专用加速器显存。
核心系统围绕八个 Intel Gaudi2 加速器构建,这是主要 AI 实验室用于大规模语言模型训练的同级别硬件。它在单个机箱中承载 768 GB 高带宽内存,可处理持续的大规模训练工作。
两个辅助系统是基于 NVIDIA GPU 的服务器,配置用于推理、微调和分析工作负载,是经过验证的生产级 AI 应用平台。
所有三个系统均运行 Ubuntu Linux LTS,配备镜像存储和内置远程管理功能,以确保可靠性。
基础设施概览
| 功能 | 支持内容 | 客户获益 |
| 24 个 AI 加速器 | AI 和分析工作负载的并行处理 | 更快速地开发 AI 赋能工具和自动化 |
| 1.25 TB 专用加速器显存 | 更大的模型和数据集 | 更强的复杂业务数据分析能力 |
| Intel Gaudi2 训练加速器 | AI 训练和模型开发 | 反映 Reconext 工作流和客户需求的定制工具 |
| 配备 NVLink 的 NVIDIA V100 GPU | 推理、微调和分析 | 经过验证的 AI 工作负载和面向生产的业务应用 |
| 每台服务器 1 TB RAM | 大规模数据准备 | 减少处理大型业务数据集时的瓶颈 |
| 快速 NVMe 和分层存储 | 快速访问模型、数据集和工作文件 | 加速分析和 AI 开发周期 |
| 高速 100GbE 网络 | 系统间的大型数据集传输 | 更快的处理速度以及与内部系统更好的集成 |
| 镜像存储 | 防止驱动器故障 | 支持重要工作负载的可靠性和连续性 |
| 带外管理 | 远程监控和故障排除 | IT 部门可以更快响应并更高效地维护环境 |
| Ubuntu Linux LTS | 稳定的运行平台 | 为安全、可维护的 AI 开发提供持久基础 |
工作开展地点
Reconext 的每个核心服务线都能从中获益。内部 AI 环境使团队有能力在 Reconext 基础设施内,利用真实的计划数据运行这些功能。
ITAD 计划
AI 可以加速资产分类、发现回收趋势,并标记人工审核可能遗漏的异常情况。曾经需要手动汇编的报告现在可以自动生成。
DCD 计划
大规模数据中心退役涉及许多变动环节。AI 可以支持预测性规划,标记复杂数据集中的异常,并让客户更清晰地了解项目状态。
维修、翻新和生命周期服务
AI 辅助诊断和故障趋势分析使质量和周转时间更加一致。当模式识别为零件预测提供信息时,预测会变得更加可靠。
跨所有计划
自动化报告、服务团队的内部副驾驶 (Copilot) 以及面向客户的仪表板都已触手可及。每个案例的目标都是相同的:客户无需询问即可获得所需信息。
后续计划
基础设施已经到位,Reconext 团队正积极将其应用于各个计划。对于客户而言,这意味着 AI 辅助功能不再仅仅是路线图上的愿景。它们现在即可使用,并正被融入我们的工作方式中。
如果您想了解这些功能具体如何应用于您的计划,请联系我们。